
一组神经元能为许多位置编出不同的活动模式,却可能在两个相距很远的地方,只留下一个细胞的差别。要靠带有随机性的脉冲认出这点差别,就得等待。怎样分配有限的细胞,才能兼顾位置分辨率与辨认速度?格物的研究员在一种理想化的周期编码模型中,给出了任何设计都绕不开的速度界限。
走过一段路后,同一个神经元又活跃起来。这在大脑的定位系统里,并不稀奇。2005年,Torkel Hafting、Marianne Fyhn及同事报告,鼠脑内嗅皮层的一类细胞,会在动物走到一系列规则排列的位置时反复活跃。这些位置在平面上组成三角网格,细胞因而得名“网格细胞”。单个细胞报出的信号会重复,多个细胞的活动组合才有望帮助区分位置。原始研究
重复有一个诱人的好处:同一套局部图案可以铺展到更大的空间。但它也带来危险。假如两个地方恰好相隔一个重复周期,仅凭这个周期的信号,就无法知道自己在哪一处。增加更密的图案能提供细节,却也会让重复发生得更频繁。要让这种表示位置的方式真正可用,既要问它能区分多少位置,也要问它需要观察多久才能分清。
格物的研究员研究的,正是后一个问题。新论文给出的答案适用于一套严格限定的数学模型:位置在一条环形跑道上,细胞的放电率只有高、低两档。最粗的一组以整圈为周期,其余组的周期逐级按整数倍缩短;每个细胞在每个周期的一段连续区间内采用高放电率。它把各种允许的细胞安排放在一起比较,确定了最佳辨别时间如何随精度要求和细胞总数变化。随附论文
很远的两个位置,也可能只差一个细胞
先把环形跑道拉直,首尾仍然相接。设整圈长度为一。一个模型细胞在前半圈保持高放电率,后半圈保持低放电率;另一个细胞每半圈重复一次,第三个每四分之一圈重复一次。后两个细胞也各自在自己的半个周期内保持高放电率。
把高、低两档分别当成亮、暗,就得到三行条带。每次沿跑道移动,都能同时读取三行。三行合起来,把一圈分成八段,每段都有独一无二的亮暗组合:粗的一行区分大区域,细的一行补充更小的差别。
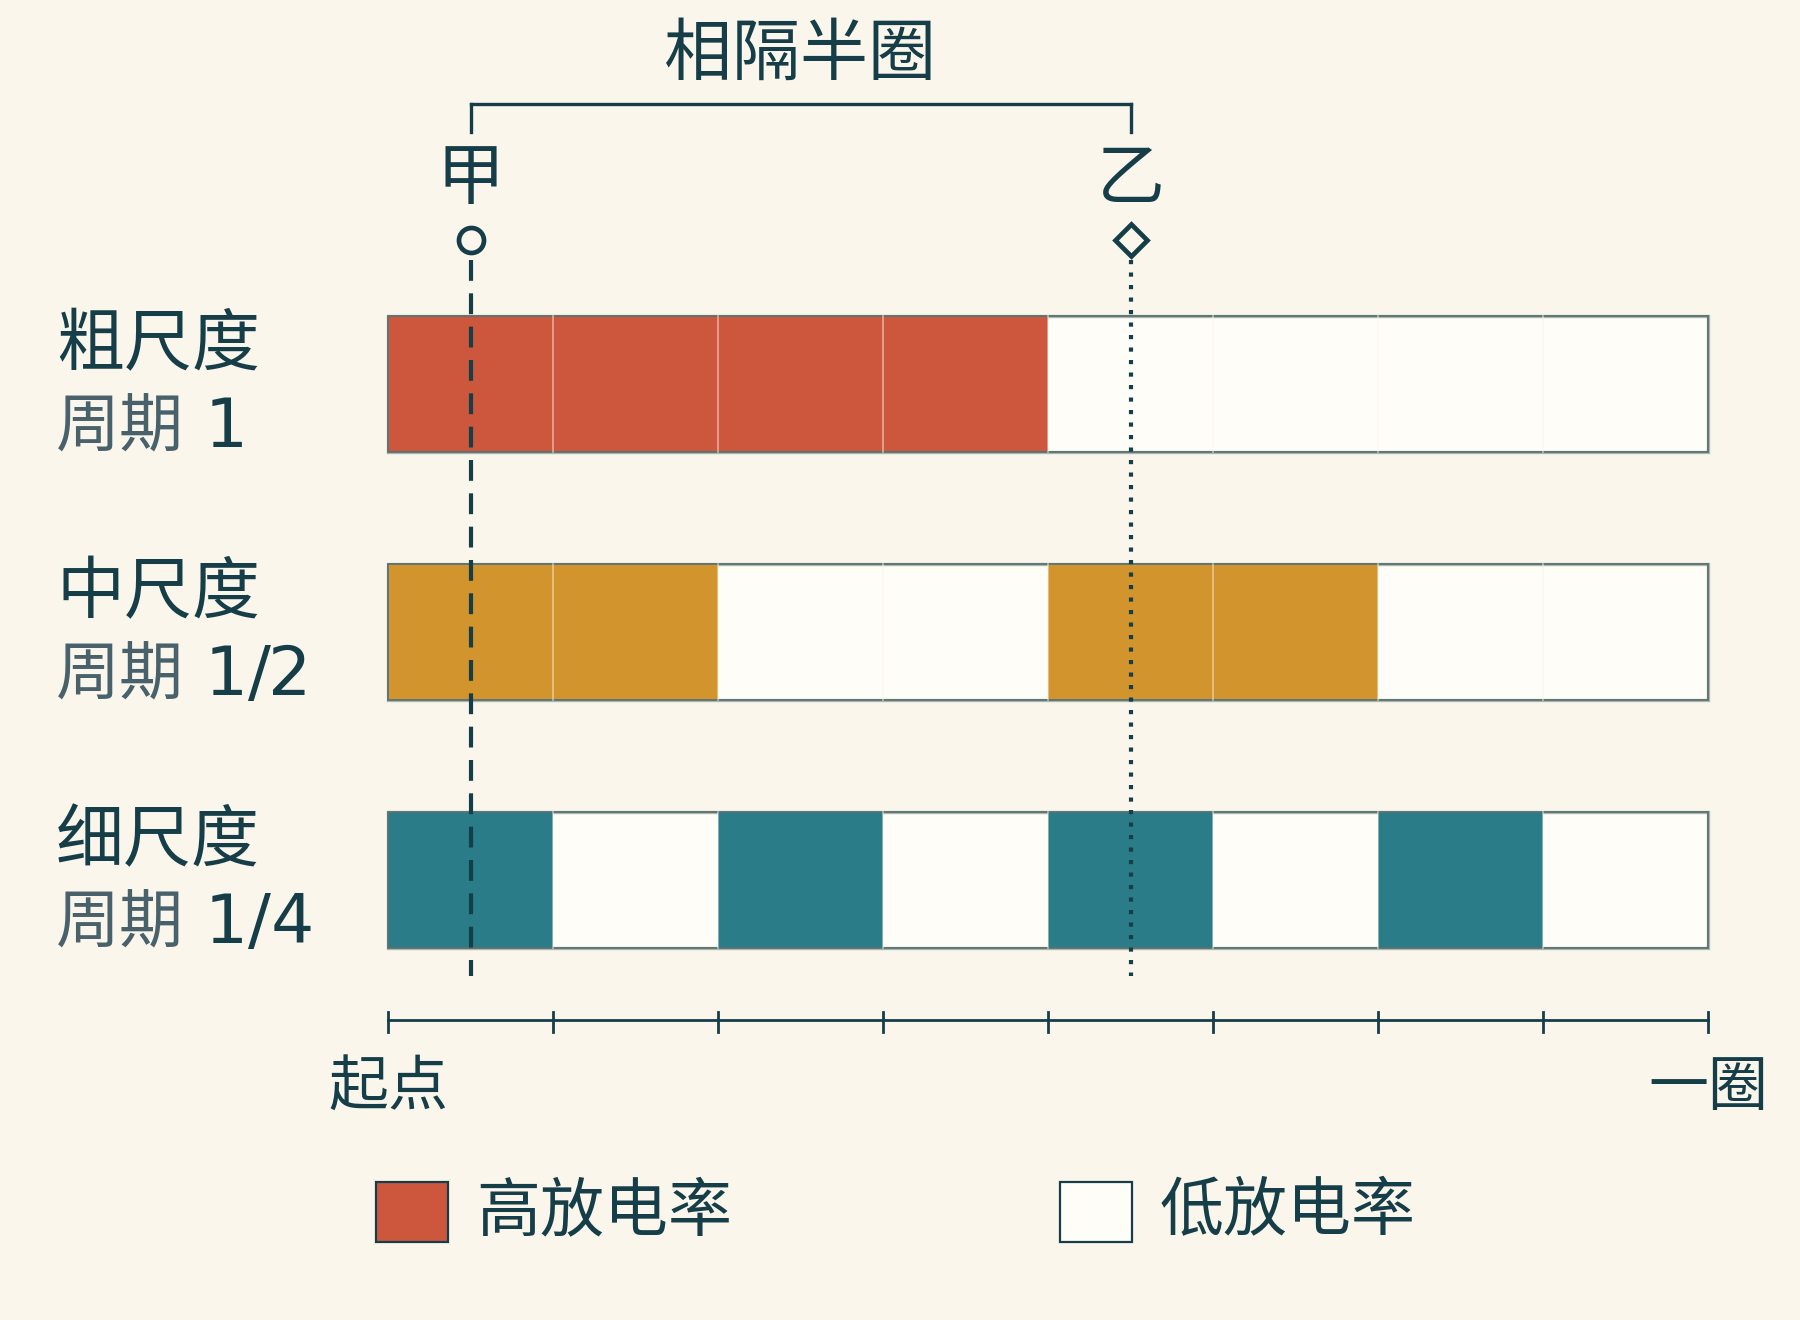
细胞很少,却能组合出很多模式。不过,选出图中的甲、乙两个位置,它们相隔半圈,第二、第三个细胞给出的信号完全相同,只有第一个细胞改变了放电率。即使继续增加周期更短的细胞,只要这些周期仍是一圈长度的一半、四分之一、八分之一……,它们也会在这两个位置重复。
这说明,“可区分的模式很多”与“每一对模式都很容易区分”,是两回事。后者取决于具体有多少细胞能提供差异。
这里的亮、暗只是在画放电率,不能把它们当作读一次就准确无误的灯。神经元发送的是一串脉冲。作为这一数学框架的统计基础,Guilherme Ost和Patricia Reynaud-Bouret用相互独立、按固定平均速率随机出现的脉冲来描述它们。短时间里,放电率高的细胞也可能没发出几个脉冲;放电率低的细胞也可能碰巧多发几个。因此,辨认位置需要积累证据。统计模型与辨别框架
假如两个位置让所有细胞的放电率都相同,观察再久也无法区分它们。假如有很多细胞在两处的放电率不同,就有更多独立的证据可用,所需观察时间可以缩短。
论文把这种关系化成了一个计数。比较两个位置,数出从高放电率变成低放电率的细胞,再数出反方向变化的细胞;取两个数中较大的一个,记为 。在固定高低放电率和一个足够小的允许错误率后,辨别所需时间与 同数量级。因此,论文直接把一对位置的归一化辨别时间定义为
其中, 衡量这对位置有多难分清;若 ,便把它记为无穷大。这是一种剔除了固定系数的时间指标,不能直接读作多少秒。
精度和速度,要分享同一批细胞
接下来,还需要说清“最好”是什么意思。
先指定一个距离要求 ,它表示一圈长度的某个比例。我们只要求分清相隔至少 的两个位置;更近的位置允许不作区分。环上距离取两条连接弧中较短的一条,因此最大的距离是半圈。
对于一种固定的编码,找出所有符合要求的位置对中,辨别时间最长的那一对。这衡量它在最不利情况下的表现。再允许设计者重新选择分多少组、每组有多少细胞、各组周期多长,以及每个细胞在哪段位置保持高放电率,寻找最好的安排。这种“先看最坏表现,再选最佳设计”的问题,称为极小极大问题。
这里比较的是两个已知候选位置:根据脉冲判断“在甲还是在乙”。它并不等同于只凭脉冲,从整条跑道中估计出一个未知坐标。
格物的研究员证明,如果总共有 个细胞,要求的距离小于 ,无论如何安排,总会有符合距离要求、却无法辨别的位置对。到了 ,就已有设计能让所有符合要求的位置对可辨。这道分辨率门槛在此前的研究中已经得到;新工作补齐的是从这道门槛开始的最佳速度。
在 的范围内,最好的归一化辨别时间 满足
这里, 和 是不随细胞数或精度要求变化的正的常数; 表示以二为底的对数。两边界限还没有合成一个精确数值,但已经夹定了变化的数量级。
为什么出现对数?把一圈对半细分三次,就到八分之一圈;细分六次,就到六十四分之一圈。 正是这种连续对半细分的次数。结果表明,最优时间的数量级由这项精细程度除以细胞总数决定。要求越精细,有限的细胞就越难保证快速辨别;若精度要求不变,增加细胞则可以加快辨别。
一个只有六个细胞的例子,能让这个取舍变得具体。第一种安排,让六个细胞分别负责六种逐次减半的周期。这样可把一圈分成六十四段,但仍有相隔半圈的位置只差一个细胞,归一化辨别时间被这一弱点卡在一。
第二种安排,只保留最粗的三种周期,每种各用两个活动区间完全相同的细胞。这样只能区分八段,却让每一处原有的细胞差异都有了两份独立的脉冲证据。对于相隔至少八分之一圈的任意两个位置,归一化辨别时间缩短到二分之一。
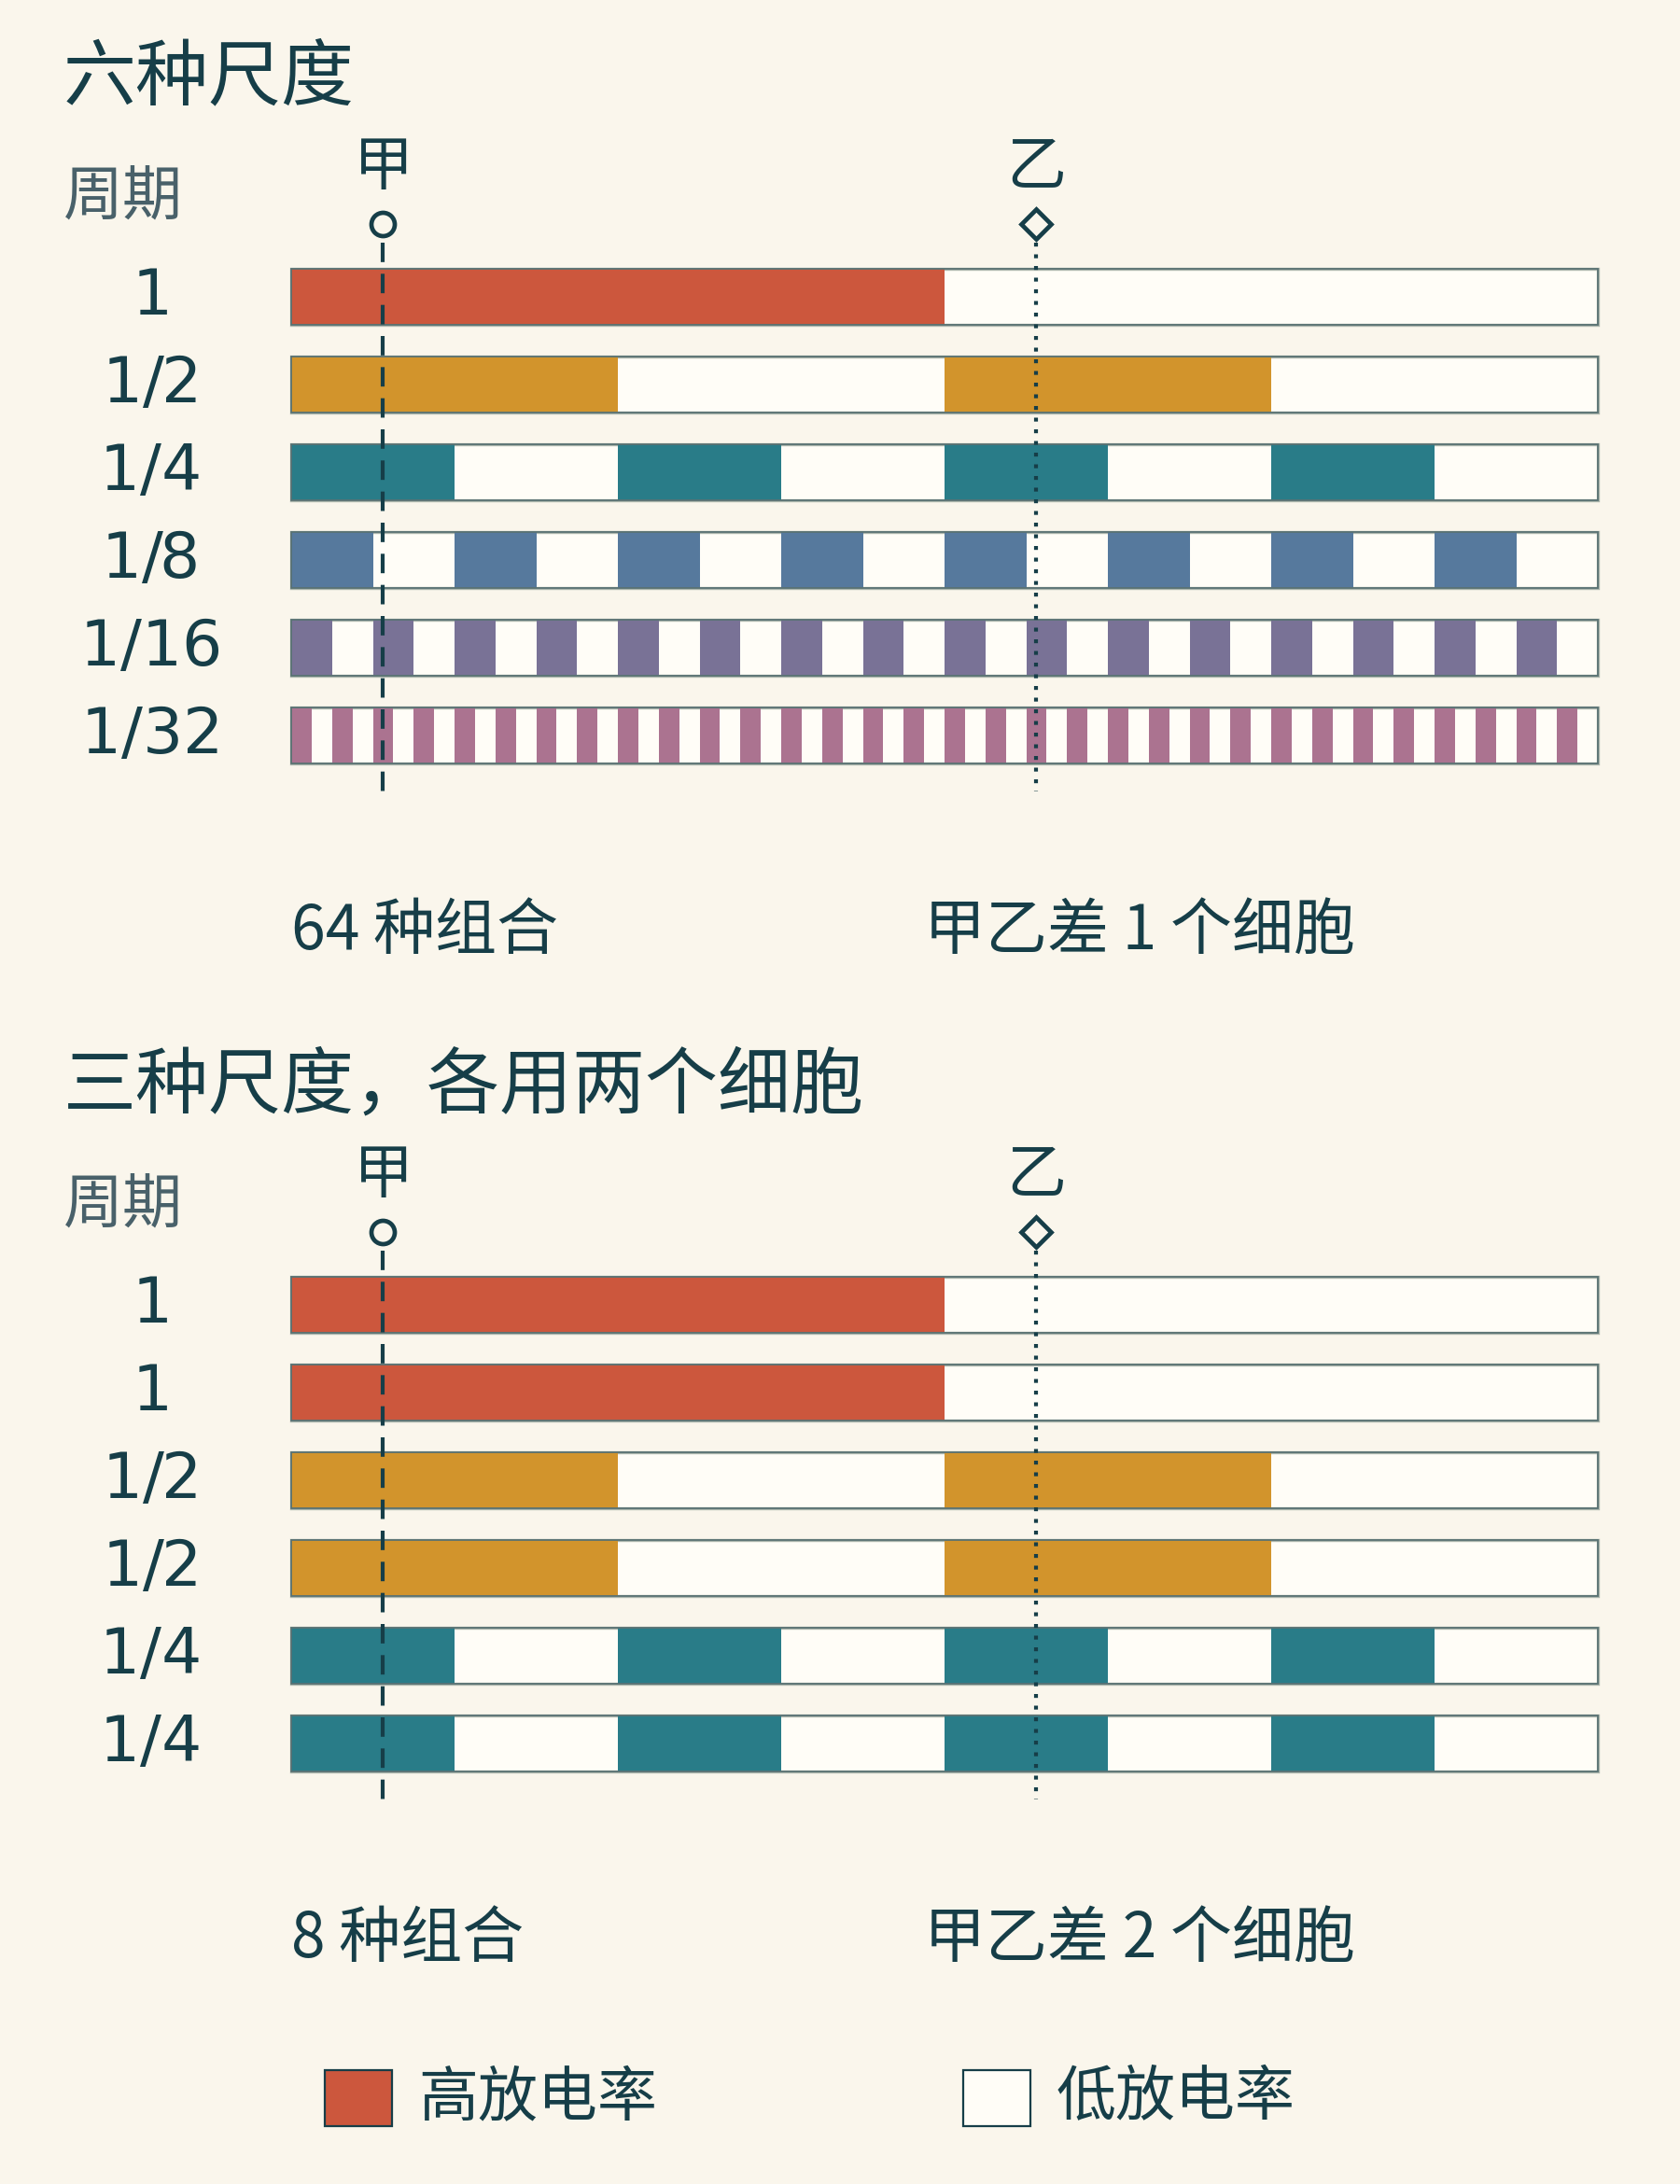
同样多的细胞,分到更多尺度上,可以换来更细的分辨率;把它们用于重复已有信号,则可能加快较粗任务中的辨别。但这个例子只比较了两种安排。也许把各组人数分得不均匀,或者让周期按三倍、五倍缩短,就能比两者都做得更好?
此前,Ost和Reynaud-Bouret已经给出一些好设计,也留下了这个问题:允许整个结构都变化后,还能快多少?新论文的关键,是给所有允许的设计加上一条共同约束。
每个尺度的短板,都要用细胞来补
证明的出发点,仍是图一中那个相隔半圈的位置对。
当位移恰好等于某个周期,具有该周期的细胞就会给出相同信号。由于模型规定大周期是相邻小周期的整数倍,更细的组也会一起重复。这时,区分两个位置的负担便落到较粗的组身上。
把位移换成另一个周期,就会得到另一组这样的考验。即便一个设计对某类位置对很敏感,也可能在别的尺度上暴露短板。要让最坏位置对也能迅速分清,就必须同时照顾这些考验,不能只在局部安排密密麻麻的活动区间。
旧研究已经把这件事写成了针对固定结构的下界。不过,其中同时出现了各组人数、周期和精度要求。想比较所有结构,就不能停留在为某一组参数算出一个答案。
格物的研究员用了一个名为“Abel求和”的有限求和恒等式。它可以把一笔总和,改写为若干部分和的加权总和。在这里,各部分和记录从粗到某一级尺度为止的细胞贡献,而权重来自相邻尺度之间的差。
关键是,这些权重全都非负。于是,每一级为了避免短板而必须满足的贡献下限,都能代进去相加,不会因为正负抵消而失去约束。重新整理后,算到的仍是同一笔总细胞预算。要让所有尺度上的辨别都快,就得为这些要求共同付出细胞。
这种算法也管住了“跳过尺度”的办法。周期可以一次缩短很多倍,但相应约束的权重也会变大。证明把连续缩短的尺度比转成对数后,各级贡献累积起来,只留下从一圈到目标精度的总跨度。无论中间分了多少组、在哪些尺度多放了细胞,都逃不掉与 成比例的预算要求。固定总数后,能保证给所有位置对的差异计数,至多是 的一个固定倍数。再取倒数,就得到了任何允许结构都不能突破的时间下界。
下界还必须配上能达到相应数量级的设计,否则它可能只是一个宽松限制。论文的另一半来自已有构造:在细胞足够多时,使用周期逐次减半的若干组,把人数尽量均匀分配,并适当错开每个细胞的高放电区间,就能达到所需的速度数量级;接近分辨率门槛时,则用每组一个细胞的精细构造接上。两者共同给出上界。
所以,新进展的意义在于把“有一种安排做得到”推进到“所有其他允许的安排,都不可能在数量级上无限胜过它”。精细定位的速度代价,由此成为这整个模型类别的性质。
一个任务的最优,还不是所有任务的最优
这个答案仍然留着一个与大脑尤其相关的问题。论文允许针对不同的距离要求,重新选择整套编码。它没有证明,同一套固定的细胞结构,能够同时在很多种精度要求下达到各自的最优速度。
区分道路两端和辨认脚边的微小移动,需要的精度不同。如果每次都得重建位置信号,单项任务的最优就未必能说明实际使用中的效率。要回答这个问题,还需要找到一套同时适用于多种距离要求的编码,或者证明这样的编码不可能存在。
真实网格细胞也超出了本文的设定:活动并非整齐的高低阶梯,空间不只有一维,不同周期未必严格按整数嵌套。论文没有证明真实大脑达到了这条界限,也没有给出动物的反应时间。它提供的是一个边界清楚的理论基准;论文同时注明,结果仍待领域专家进一步验证。
回到那两个相距很远、却只有一个细胞不同的位置。细密的空间图案,足以制造许多不同的地址,却未必给每两个地址留下足够多的辨认线索。这项研究把两件事放到了同一笔预算里:细胞既要表示位置的细节,也要在最难分清的地方,提供足够快的回答。
本文依据随附论文《The Minimax Discrimination Rate of General One-Dimensional Periodic Grid Codes》。封面与正文配图均为原创程序绘图;正文图为模型示意与小规模精确计算,绘图源文件和核查说明随文交付。