
把一团正在碰撞的气体里每个粒子的速度同时反向,它就会沿原路返回。可如果只照着这一刻的位置、速度统计,重新准备另一团气体,它能有多大机会看起来也在倒放?两团气体的单粒子统计可以相同,未来却取决于统计表没有记录的粒子间关联。格物的研究员在一个稀薄硬球模型中,把这份差别算成了一个概率指数:先前的熵增越大,新气体越难通过指定的倒放检验。
相同的统计,不同的过去
先想象一群只在接触时发生弹性碰撞的小球。没有摩擦,也没有碰撞造成的能量损失;两次碰撞之间,小球沿直线运动。只要把所有速度精确反向,以前撞开的一对小球就会重新靠近,经历反向的碰撞。这正是洛施密特可逆性问题的核心:微观规则既允许正着走,也允许倒着走,为什么气体的日常行为却有鲜明的时间方向?
描述气体时,我们通常不会列出全部小球的位置和速度,而是问:从中随机挑一粒,它落在某个位置范围、具有某种速度的概率有多大?把这些概率汇集起来,就得到单粒子分布。它同时包含位置和速度,比温度、压强等少数几个数详细得多,却仍没有告诉我们每个粒子与其他粒子如何配合。
这里的“关联”有一个具体含义:知道一个粒子的状态,会改变对其他粒子状态的判断。碰撞正是建立这类关系的过程。两个球碰撞后,速度受到共同的能量、动量守恒约束;接下来它们又各自碰上别的球,关系便牵涉更多粒子。单粒子分布会保留速度统计的变化,却不会逐项保留这些共同约束。
所以,给精确反向的气体拍一张统计意义上的“快照”,再按照这张快照抽取粒子状态,并不能复制原来的气体。原来那团保留着此前演化产生的关联;新准备的那团只遵循指定的单粒子分布,以及小球不能重叠的条件。它没有被要求保留同一份碰撞历史留下的关系。
这也解释了为什么不能仅凭相同的单粒子分布,就认定两团气体此后必须服从相同的宏观变化。早先,Thierry Bodineau、Isabelle Gallagher、Laure Saint-Raymond 和 Sergio Simonella 对硬球极限的研究,已经指出初始关联中的细节如何影响时间方向。两种制备的区别有深厚的理论背景。《玻尔兹曼—格拉德极限中的单侧收敛》
格物的研究员要追问的是一个更定量的问题:如果指定一项真正反向的气体几乎总能通过的检验,新气体偶然通过它的概率到底有多小?
熵增没有抹去微观信息
玻尔兹曼方程用单粒子分布追踪气体随时间的变化。对于适当的孤立气体,它给出的一个核心结论是:由单粒子分布计算的熵不会下降。可以先把这种熵理解为,只看一粒小球的位置和速度时,统计描述中有多少不确定性。碰撞改变速度的分配,这个不确定性可以增长。
但如果记录整团气体的联合概率分布,结论就不同了。硬球动力学一一对应地搬运微观状态,并保持它们在相空间中所占的体积。相空间只是把所有粒子的位置和速度一起列出的空间。在这种演化下,从完整分布计算的细粒度熵保持不变。
两者并不矛盾。一个联合分布的熵,与把各粒子当作互相独立时得到的熵之差,恰好衡量整体关联。只看单粒子时,可能性显得更多,因为描述漏掉了哪些粒子状态能够共同出现的限制。于是,单粒子熵可以增加,完整分布的熵却不变。
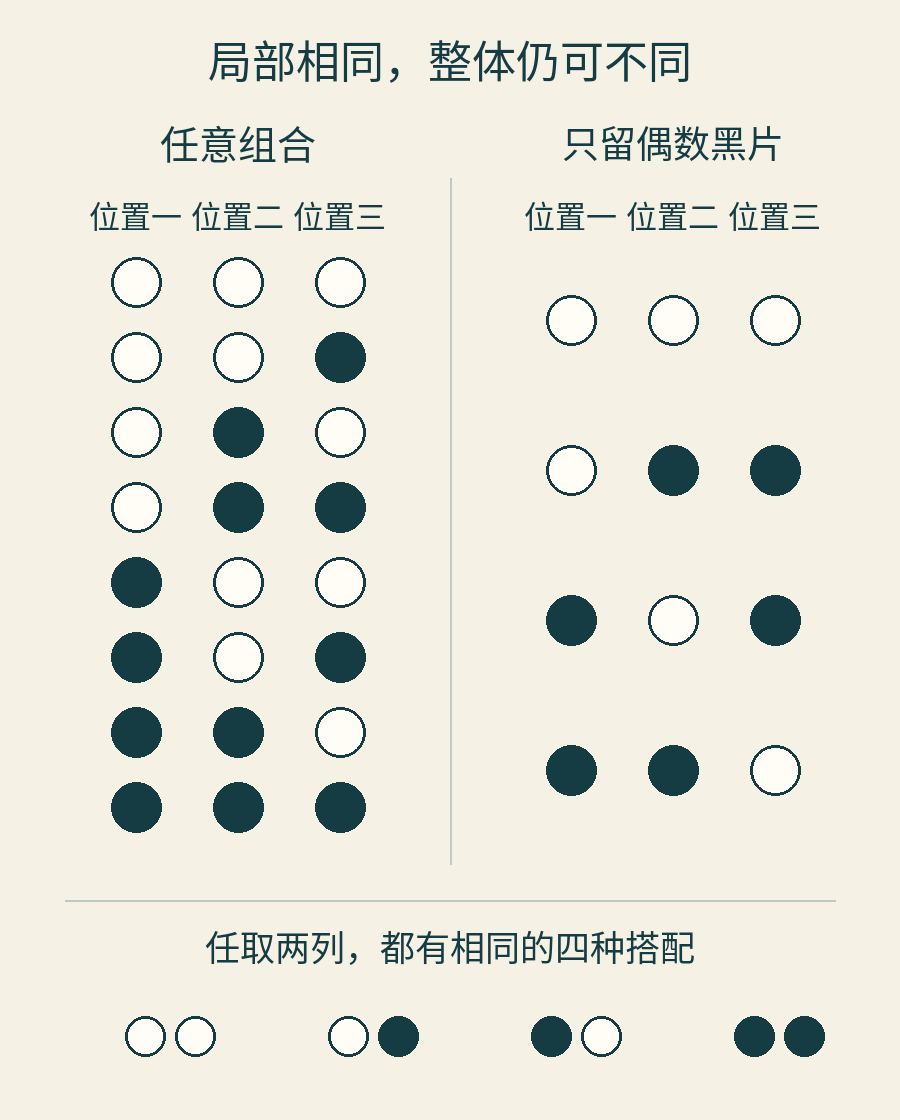
一个很小的例子就能显示这种区别。设三个位置各放一个黑色或白色圆片。第一种准备方式允许全部八种组合,且每种等可能;第二种只允许黑片数为偶数的四种组合,也各自等可能。单独看任何一个位置,两种方式里黑白都各占一半。甚至任取两个位置,四种黑白搭配也都各占四分之一。然而,同时看三个位置,就能发现第二种方式只允许一半的组合。它的限制存在于三者共同的关系里。
真正的气体有远比圆片多的可能状态。要证明上述信息账目在微观模型通向玻尔兹曼方程的过程中依旧成立,需要处理一个棘手的极限:小球越来越小,数量越来越多,所占空间的比例趋于零,但每粒经历碰撞的尺度仍保持有限。这就是玻尔兹曼—格拉德极限。它让气体足够稀薄,同时不把碰撞的影响一并删掉。
Yu Deng、Zaher Hani 和 Xiao Ma 此前证明,在玻尔兹曼方程的解存在并满足规定界限的时段内,适当准备的硬球气体,其少数粒子的统计能够逼近玻尔兹曼描述。这个结果提供了从可逆碰撞规则到单粒子方程的数学桥梁。它也给出了本研究需要的底层估计。Deng、Hani、Ma 的原论文,第 3 版
不过,分布已经接近,并不自动意味着熵也接近:很罕见的状态仍可能在熵的计算中占据不可忽略的分量。格物的研究员进一步控制碰撞历史以及这些罕见部分对信息量的贡献,才把信息账目带过了这个极限。
结果是:在论文的制备方式下,整体关联信息除以平均粒子数,趋近此前单粒子熵的增加。与此同时,按论文的抽样方式只挑出两粒,它们之间平均可测的信息关联却趋于零。这并不意味着全体独立,正如圆片例子里,两列统计完全独立,三列却受共同规则约束。论文还证明,在相应的抽样方式下,一粒与其余全部粒子之间的信息关联保有正的下界。
这里“平均”有必要说清楚。论文允许不同次准备的粒子总数有所波动,随后每次演化都守恒粒子数。整体关联先在各个确定粒子数的情形内计算,再按制备概率平均;抽取一粒时,粒子多的情形更容易被抽到。格物的研究员把粒子数波动本身携带的信息单独分离,才确认主要的信息量确实在粒子间的关联中。这个结论没有直接推广到任意预先指定粒子数的气体。
因此,新的严格结论并非“碰撞会产生关联”这一直觉,而是:单粒子描述所显示的熵增,能在这个稀薄极限中逐粒归入整体关联的信息账目。
把信息差别换成误报概率
现在回到两团气体。让原气体从时刻零演化到一个固定的时刻 。格物的研究员比较两种准备:一种将此刻全部速度精确反向,称为 ;另一种按反向后的单粒子分布重新抽样,并排除重叠的小球,称为 。两者在稀薄极限中的单粒子分布相同,有限小球直径下的实际分布和粒子数统计可以略有差异。随后让两团气体都再演化时长 ,使用同样的碰撞规则和同一项检验。
把原气体的单粒子熵增记为
这里 、 分别是原气体在起点和终点的单粒子分布, 表示由该分布计算的熵。论文采用自然对数,并把玻尔兹曼常数取为一;位置、速度也使用同一套固定的无量纲参考单位。这样, 就是每粒子的无量纲熵增。以下讨论的是 为正的情形。
概率不能脱离检验内容来谈。论文的检验要求观察者在反向运动的起点、终点分别计算一项评分:将每粒当时的状态代入对应的目标单粒子密度,取其对数,再对全部粒子求和、归一化。起点的目标是原气体终态的速度反向版本,终点的目标是原气体初态的速度反向版本。两项评分都必须接近真正倒放时的预期值。还可以附加有限个中间时刻的观测,例如指定位置和速度范围内的粒子比例。
为什么这样选评分?因为它们合起来,恰好能回答统计判别中的一个基本问题:同一个微观状态,在 制备下相对于在 制备下,有多常见?这个概率密度的比值称为似然比。比值很大,就意味着该状态更支持 。
通常,要比较整个气体的概率,似乎得知道途中所有碰撞如何发生。这里,可逆且保持体积的演化大幅简化了计算:要算真正倒放制备给某状态的权重,可以把它沿动力学送回对应的原始准备,再读取最初的概率密度。与新准备的乘积密度相除后,似然比的对数就只剩下上述两项端点评分的差,加上一项在每粒子尺度上消失的归一化修正。
证明的下一步同样关键:在真正倒放的制备下,这个对数似然除以平均粒子数,会集中到 。也就是说,绝大多数真正倒放的样本,都比同一状态在新制备下的权重大约多出一个以“平均粒子数乘熵增”为指数的因子。端点对数可能很大,因而这一步还需要控制远处粒子和高速粒子的贡献,不能只靠普通的平均规律。
这就把熵增变成了误报概率。对论文构造的检验事件 ,如果随着极限推进,让评分容差足够缓慢地收紧,就有
和 分别表示两种制备下的概率; 是 制备的平均粒子数,在极限中趋于无穷; 表示除以 后趋于零的修正。第一项说,真正倒放的气体几乎总能通过。第二项说,新气体被同一检验当作倒放的概率,在主要指数上由此前的熵增决定。对同样的正熵增,平均粒子数越多,这类误报就越罕见。
这个指数还有判别意义:如果要求真正倒放样本的接受率不低于一个介于零和一之间的固定值,那么任何判别办法都无法在主要指数上把误报概率压得比它更低。论文构造的检验能达到这个界限。
但 不是“发生了任何一种熵减”的统称,更不是重新逐粒复制一整条轨迹。指数对应的是明确定义的两种制备和指定观测。论文也不需要先证明新气体此后如何典型地演化;真正倒放的历史,由原来已受控制的正向历史和微观可逆性保证。对新气体重启一遍玻尔兹曼方程,需要另行核查条件。
有限读数,仍须顾及全部粒子
端点对数评分给了理想答案,却要求读取每粒的精确信息。若仪器只能输出有限种读数,区分能力会不会随之消失?
乍看之下,这与前面的整体关联结论还有些冲突:只看几粒小球,几乎发现不了关联,为什么少量读数反而能认出倒放?关键在于,“读数有限”和“只观察固定几粒”是两回事。一份覆盖全体粒子的直方图,只输出有限个数,却汇总了大量粒子的状态;而且这里比较的是两个时刻。
格物的研究员据此构造了一个有限读数方案。先在位置和速度共同组成的空间里划出有限个格子,统计每格有多少粒子,用已知的粒子数尺度归一化,再以固定精度报告。只要目标分布连续且处处为正,格子内的对数权重就可以用代表值近似,从而用分箱统计近似评分。
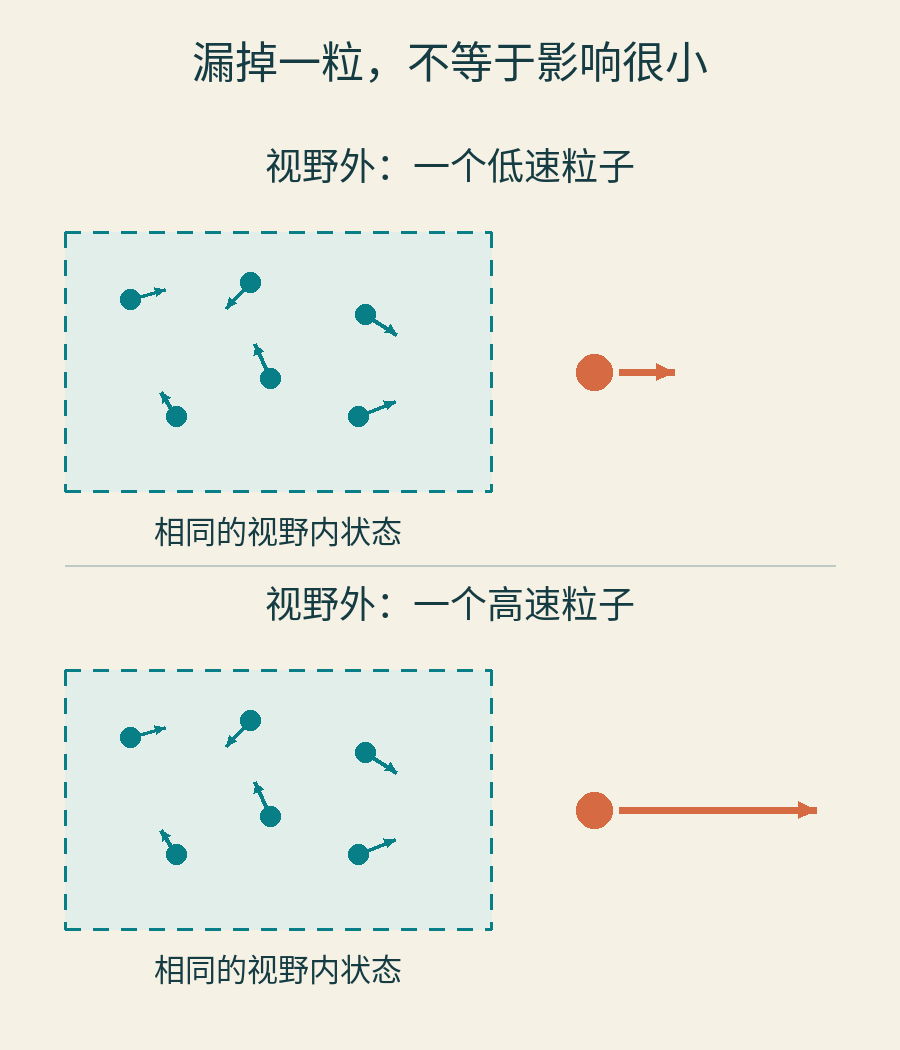
真正的难点藏在格子之外。无边空间不可能被有限个有界格子覆盖;仅仅记录“有几粒超出视野”,又不能保证被忽略的评分很小。一粒速度极高的小球,就可能携带足以影响整体判断的能量。
因此,方案在两个端点都增加一个覆盖全部粒子的加权总量。每粒的权重是
是位置, 是速度; 表示离参考原点的距离, 与动能成正比。这里各项仍使用模型固定的无量纲单位。把全部粒子的 相加并按已知尺度归一化,就同时约束了粒子数、远处粒子和高速粒子。这个尺度由制备参数确定,在极限中与平均粒子数之比趋于一。
在论文的条件下,对数权重的绝对值可以由 的常数倍控制。于是,从全局总量中减去视野内各格至少贡献的部分,就得到视野外加权贡献的上界。若上界足够小,便能逐条保证这次读数漏掉的评分不大。这个做法无需假定新气体里危险的高速异常粒子已经足够罕见。
结论是:先指定一个小于 的正数 ,把它作为允许的指数损失,就能在小球直径趋于零之前,选定格子、读数量程、精度和接受规则。真正倒放样本的接受率仍趋于一;按平均粒子数归一化的负对数误报概率,其极限下界至少是 ,极限上界至多是 。换句话说,即便它没有单一极限,其主要指数也会被夹在两个相距仅 的界限之间。只要愿意重新选择足够精细的有限装置,就能让损失任意小。
这不是说同一台固定仪器一定取得精确的完整指数。固定的精度针对的是归一化后的集体读数,也没有把测量越来越多粒子的总成本固定下来。若考虑仪器噪声,还需充分准确、有保证的误差范围;偶尔无提示地报错,也可能淹没原本指数稀少的误报事件。论文证明的是满足这些条件的读数方案存在,没有给出一套已实施的实验装置。
时间方向也写在准备方式里
把粒子间的关联与熵联系起来,是统计物理中的老思想。这项工作的推进,是在一个明确的硬球模型中,把关联信息、两种准备的似然差别和可观测检验的误报指数接在了一起。它让“真正倒放的气体很特殊”成为可以计算、也可以讨论有限精度读取的问题。
这些结论的适用范围同样具体:气体处于全空间,先选定一个有限观察时段;玻尔兹曼方程在这个时段必须有满足规定界限的正则解;初态还需满足正性、空间衰减和矩条件。论文给出了速度分布在不同方向宽窄不同的光滑初态例子,证明在一段非零短时间内确有正熵增。它没有证明任意初态都能在任意长时间内满足要求。提供给本文的材料是一份工作稿,结果属于数学推导,没有实验或数值模拟数据。
进一步把结论变得可操作,还需要知道有限粒子数下误差有多大、为保留给定比例的指数要用多少格子,以及怎样实际测量覆盖全部粒子的加权总量。这些都需要新的定量估计或测量方案。
最初的问题现在有了更清楚的答案:复制气体的一张单粒子统计表,没有复制它的过去。那段过去留下的整体关联,使真正反向的气体能够重走来路;同样的统计表下,重新准备的气体偶然通过指定检验的机会,则受到熵增给出的指数约束。微观规则始终允许倒放。时间方向的这份定量差别,来自我们怎样准备气体,而低熵的过去为何成为起点,仍留在这个结果之外。
研究依据:《Entropy, Correlations, and Observable Reversal in a Dilute Hard-Sphere Gas》,2026 年 9 月 5 日修订工作稿。本文科学主线及图示据此整理;封面和正文插图均为原创程序绘图。